Multi-região na AWS com CloudFront, sem pagar a segunda região
Se a sua aplicação roda em uma região só, dá para ter uma segunda pronta para a emergência sem pagar por ela parada. Neste passo a passo eu mostro o que deixo montado em Ohio, o que só existe durante a crise e como o CloudFront desvia o tráfego da Virgínia.
O motivo foi a queda de 20 de outubro de 2025: na minha conta, quem estava rodando continuou de pé, mas eu não conseguia lançar EC2 novas na Virgínia. A história da queda está no post sobre a queda da AWS em us-east-1. Aqui fica a parte técnica.
O ponto de partida
Minha aplicação tem o CloudFront na borda, com behaviors que mandam uma parte do tráfego para o S3 e outra para a API. Abaixo da API, um load balancer e um target group distribuem o tráfego entre os serviços de um cluster ECS. Nessa conta são seis serviços ativos.
O cluster usa uma frota só de instâncias Spot, que são instâncias de leilão e custam bem menos. A tela de Spot Requests mostrava três instâncias (duas t3.small e uma t3.large) com 61% de economia. Em troca, uma instância cai de vez em quando e a frota lança outra no lugar. Na queda, esse lançamento era justamente o que não funcionava.
Como não dava para lançar na Virgínia, a saída foi lançar em Ohio, a região vizinha. O CloudFront é um serviço global, sem escolha de região, e é isso que deixa o desvio simples: com todo o tráfego passando por ele, ele roteia entre regiões.
O que fica montado em Ohio e custa zero
A segunda região não precisa rodar. Esta é a parte que responde ao título:
- Cluster ECS: existe em Ohio com zero instâncias. No console, a lista de clusters mostra 1 serviço, nenhuma task rodando e 0 EC2.
- Target group: fica mantido, sem load balancer associado (o console mostra "None associated"), porque target group não é cobrado.
- Peering e regra do banco: ficam prontos, como no passo 1.
- Load balancer e instâncias: só existem durante a emergência. O load balancer é o recurso que eu pago, então ele só nasce quando preciso.
Com o cluster zerado, para subir de novo basta ajustar o autoscale. Conhecer o que a AWS cobra e o que não cobra é o que permite montar isso.
1Conectar o banco com VPC peering
O banco continua na Virgínia, e a aplicação em Ohio precisa falar com ele. A ligação entre as duas regiões é um VPC peering, que conecta uma VPC à outra por dentro da rede da AWS.
- Em Ohio, em VPC, abra Peering connections e crie a ligação com a VPC da Virgínia. O meu se chama
seattle-ohio-to-virginiae está ativo. - Use faixas de IP diferentes nas duas VPCs: a de Ohio é 10.3.0.0/16 e a da Virgínia, 10.1.0.0/16.
- Na Virgínia, no security group do banco (
seattle-db), crie uma regra de entrada PostgreSQL, porta 5432, com origem na faixa de Ohio.
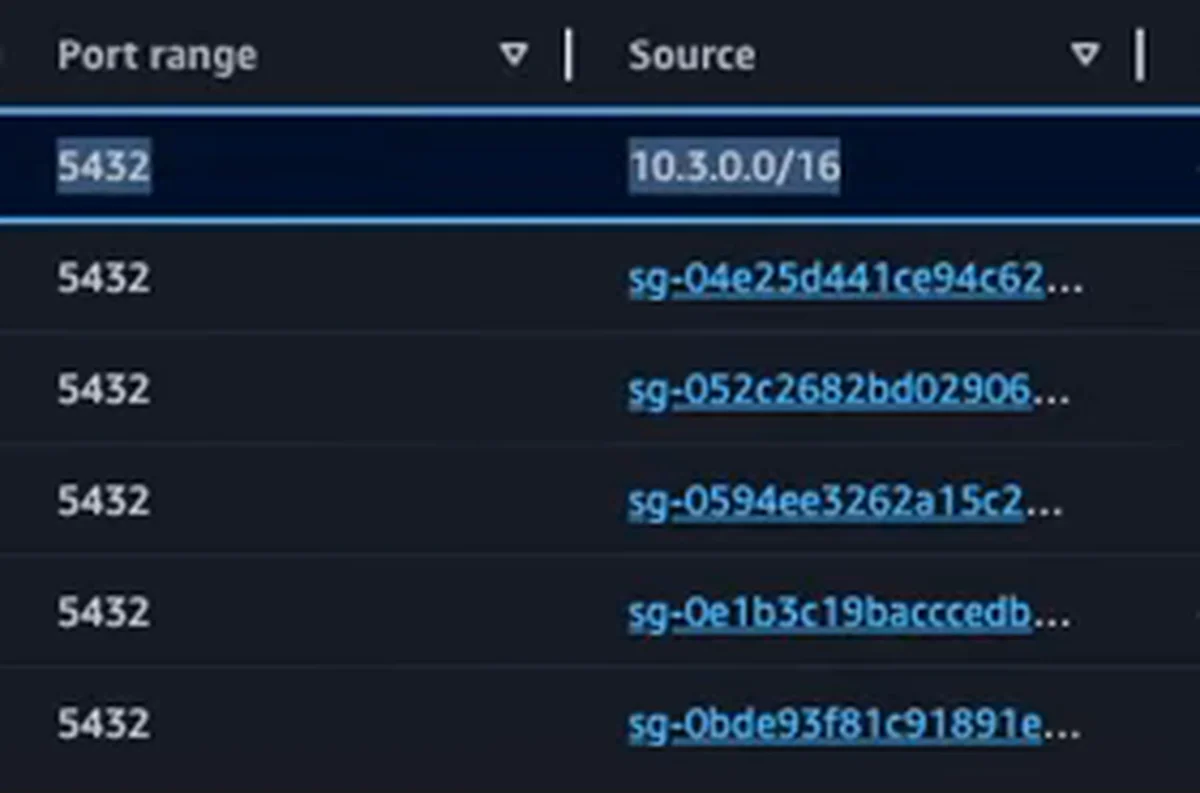
Com a regra no lugar, a comunicação funcionou.
2Subir a aplicação em Ohio
Quando a emergência chega, a ordem em Ohio é esta:
- Dar poder computacional ao cluster, ajustando o autoscale.
- Criar o load balancer e apontar para o target group que ficou guardado (o meu é o
tg-seattle-ohio, HTTP na porta 80). - Subir o serviço, a partir de uma task definition. As imagens continuam no ECR da Virgínia, e não foi preciso mudar isso.
Na primeira vez, criei o load balancer, o target group, o cluster e a task definition em Ohio. Nas seguintes, o target group e o cluster já estão lá.
3Trocar a origem no CloudFront
Com o load balancer de Ohio no ar, falta o CloudFront apontar para ele. Em Origins, crie uma origem nova com o endereço do load balancer de Ohio. A minha distribuição tem seis origens, e a primeira da lista é a de us-east-2.
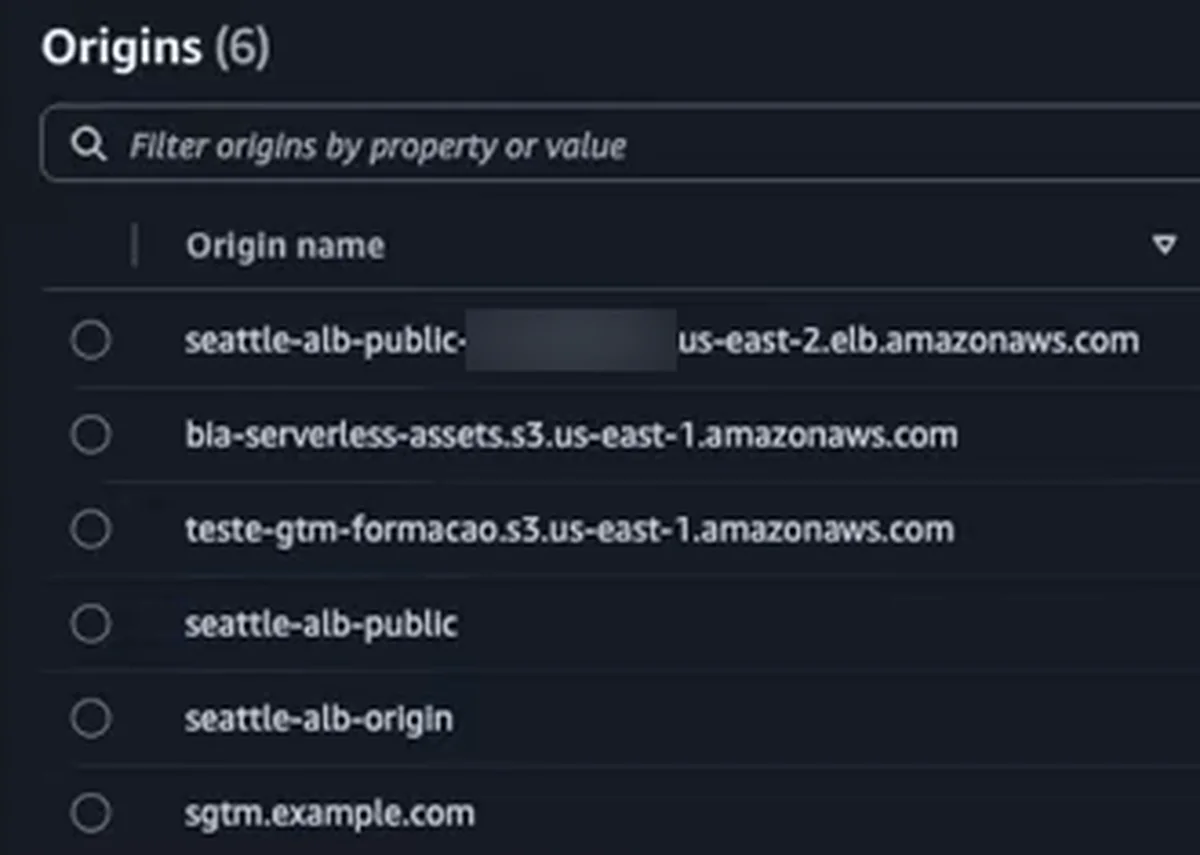
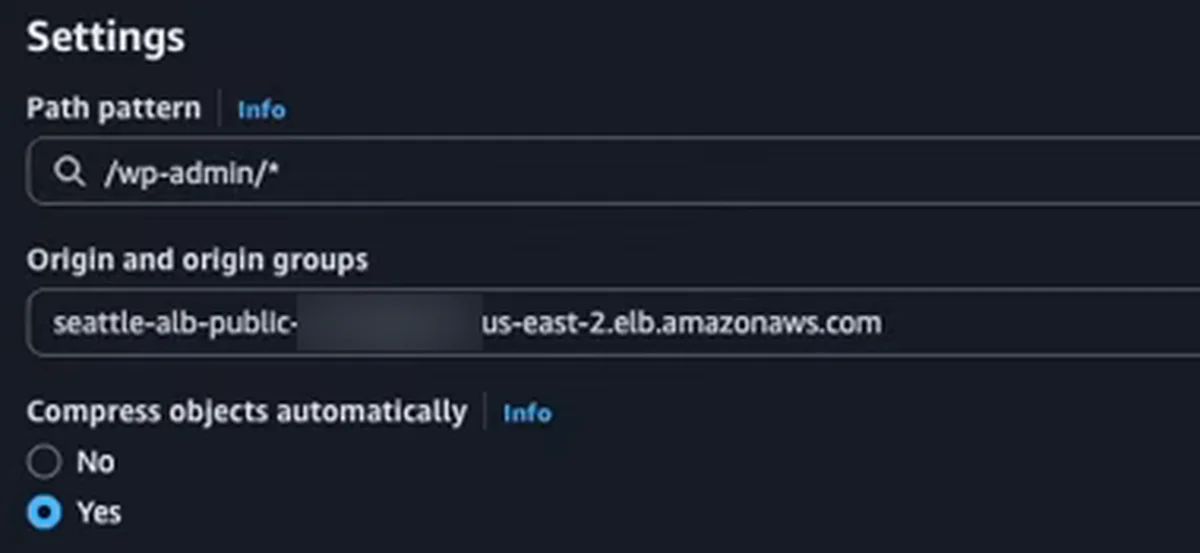
Depois, em Behaviors, abra o behavior que precisa ir para Ohio e troque o campo Origin and origin groups pela origem nova. Minha distribuição é focada em WordPress e tem 21 behaviors, cada um pensado para performance (anúncio, área administrativa e outros). Peguei como exemplo o /wp-admin/*: com a origem de Ohio, o tráfego sai da Virgínia e vai para lá.
4Voltar para a Virgínia
No dia seguinte, fiz o caminho de volta: apontei o behavior de novo para a Virgínia e tudo voltou a funcionar. Depois joguei fora o load balancer e o poder computacional de Ohio. Com tudo operando na Virgínia, meu custo em Ohio é zero.
Por que isso não pede uma arquitetura mirabolante
Naquela semana, a internet falou em multicloud, em voltar para estrutura própria e em ter infraestrutura como código para subir tudo em outra região. Minha resposta é que a solução é mais simples do que se imagina: basta conhecer os recursos.
Isso funciona para mim porque meu negócio tolera um pouco de instabilidade e porque a estratégia de cache na borda ajuda a absorver o intervalo. Avalie a sua tolerância antes de copiar o desenho.
Checklist
- O CloudFront está na frente da aplicação, com uma origem por região.
- Existe cluster ECS e target group na segunda região, com zero instâncias e sem load balancer.
- As VPCs das duas regiões têm faixas de IP diferentes e estão ligadas por peering.
- O security group do banco libera a rede da outra região.
- Sei criar o load balancer e apontar para o target group guardado.
- Sei qual behavior trocar e como voltar a origem depois.
- Revisei no site da AWS o preço de cada recurso que deixo parado.
Se a sua aplicação roda em uma região só e você quer um plano de contingência que não dobre a conta, é conversa para a gente ter olhando a sua arquitetura. A migração permanente entre regiões, para baixar custo, está no post sobre migrar de São Paulo à Virgínia.
O que os alunos dizem
“Comecei a estudar Cloud em 2023 e entrei na Imersão AWS para aprofundar minha prática.”
Luiz Claudio, Arquiteto de Soluções
Ver depoimento
“Hoje recebo oportunidades 100% remoto e finalmente me sinto recolocada no mercado.”
Patrícia Prado, Desenvolvedora Back-end
Ver depoimento
“A Formação AWS me mostrou o caminho, me deu prática de verdade e mudou minha vida.”
Rodrigo Raspinola, Analista Cloud / SRE
Ver depoimento
Formação AWS
Aprenda AWS e IA na prática, com projeto real e acompanhamento. Converse com o time sobre a Formação AWS.
Agende uma conversaPrefere assistir?
A aula completa (16 min) está no canal Domine AWS. O vídeo toca aqui mesmo.