Queda da AWS em us-east-1: o que vi e como mantive o serviço
Em 20 de outubro de 2025 a AWS teve uma falha na região da Virgínia (us-east-1) e boa parte da internet saiu junto. Conto o que vi na minha conta, por que "alta disponibilidade" não bastou e como mantive o serviço no ar levando parte dele para a região de Ohio.
O que caiu, e o que não caiu
A pergunta que mais apareceu foi se a AWS inteira tinha caído. Não: o problema estava na região da Virgínia. A AWS tem várias regiões, e o que eu vi na minha conta foi um padrão específico.
Os recursos que já estavam rodando continuaram funcionando. O que falhou foi lançar recurso novo. No meu cluster no ECS eu tinha cinco servidores; dois estavam de pé e três estavam fora, porque tentavam lançar novas instâncias EC2 e não conseguiam.
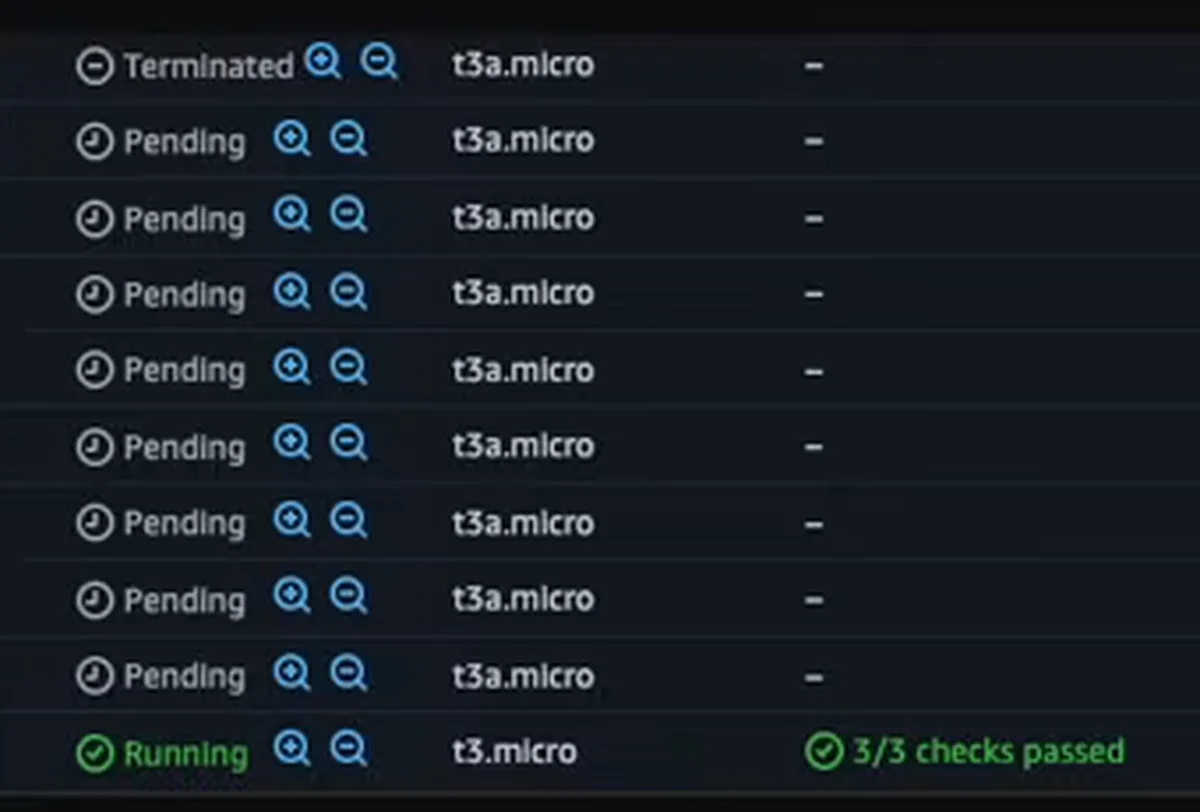
Eu trabalho com instâncias Spot, que a AWS pode tirar de tempos em tempos para eu lançar outras no lugar. Naquela manhã, essa troca dependia de lançar EC2, e lançar EC2 estava falhando.
Por que alta disponibilidade não resolveu
"A AWS não é altamente disponível? Você e as outras empresas não deveriam estar protegidos?" Deveriam, e provavelmente estavam. Só que o problema não era de alta disponibilidade entre zonas.
O relatório oficial da AWS descreve uma interrupção do Amazon DynamoDB na região us-east-1: Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia (US-EAST-1) Region. Na leitura que eu fiz durante o incidente, a AWS consome os próprios serviços. Com o DynamoDB provavelmente no centro da comunicação entre vários serviços na Virgínia, o efeito mais visível foi a dificuldade de lançar recursos novos.
Já tinha acontecido algo parecido com o S3, em 2017 ou 2018: recursos existentes funcionaram, os novos não, e até a página de status da AWS tinha problema, porque dependia do S3 na Virgínia.
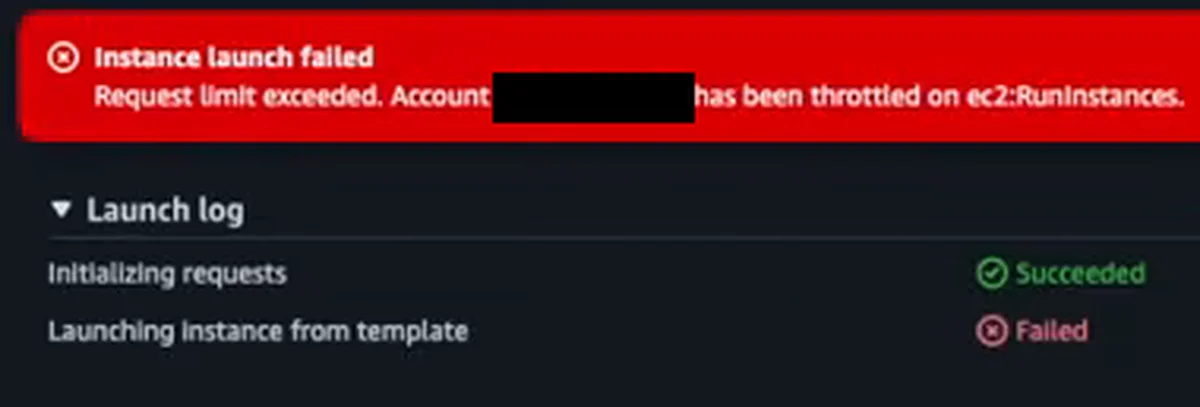
Em paralelo, a AWS limitou o lançamento de EC2. Quando eu tentei lançar uma instância na mão, o console recusou com um erro de limite de requisições excedido (request limit exceeded). O bloqueio estava na minha conta e, ao que tudo indicava, de forma global, para as pessoas pararem de bater na API de lançamento enquanto o problema era resolvido.
O que ficou fora do ar
Minha arquitetura é simples: CloudFront na borda, um Application Load Balancer com target groups e um cluster ECS com várias EC2 e vários serviços. Dois serviços entram na história: a aplicação Bia e um WordPress.
A instância do WordPress caiu de manhã e não voltou, porque não dava para lançar outra. O WordPress ficou fora do ar, e era a página onde eu ia abrir as inscrições de uma campanha. A Bia continuou operando.
A decisão: replicar só o que caiu
O raciocínio foi este. Problema de API numa região afeta o lançamento de recurso em toda a região. O que já estava de pé continua funcionando e volta ao normal quando a AWS resolve. O que eu precisava era trazer de volta só o que tinha caído.
Então escolhi replicar apenas a estrutura do WordPress em Ohio (us-east-2). O serviço da Bia ficou onde estava, porque operava normalmente. Eu tenho um agente de IA especializado em DevOps que conhece a minha conta; expliquei cada camada do que queria e ele replicou a estrutura em cerca de 20 minutos.
O banco ficou na Virgínia, e a ligação entre as regiões foi um VPC peering. Replicar o banco deixaria os dados separados, e liberá-lo como publicamente acessível trocaria um problema por outro, de segurança, muito mais grave. O banco continua sempre em subnet privada: nunca mexa nisso para resolver uma queda.
No fim, o CloudFront passou a mandar o tráfego do WordPress para o balanceador de Ohio, sem mexer no DNS. A aplicação voltou a funcionar por inteiro, parte na Virgínia e parte em Ohio, mesmo sem eu conseguir lançar uma instância na Virgínia. O passo a passo (balanceador, ECS, troca de origem e peering) está em Multi-região na AWS com CloudFront.
O que levar disso
Não é conteúdo introdutório: pede conhecimento prévio de AWS, em especial VPC, conectividade e CloudFront. Mas o ponto vale para qualquer um:
- Queda de região não é fim da nuvem. Quem tem região alternativa e as ferramentas para usá-la sai do problema.
- Cliente não espera a AWS voltar. Se não compra de você, compra do concorrente.
- Não adianta decidir a saída durante o incidente. Ter a estrutura de recuperação de desastre pensada antes é o que reduz o tempo fora do ar.
- "A AWS caiu na Virgínia" é diferente de "a AWS caiu". Entender o que aconteceu evita decidir por boato, como largar a nuvem ou voltar para um servidor próprio.
Eu só descrevo o que fiz no meu projeto. A sua arquitetura pode pedir outra solução.
Checklist
- Confira se o seu serviço depende de lançar recurso novo (EC2, instâncias Spot) numa região só.
- Decida quais serviços precisam de uma cópia em outra região e quais podem continuar onde estão.
- Mantenha o banco em subnet privada, sempre.
- Tenha a estrutura de recuperação de desastre pensada antes da queda, não durante.
Uma queda como a de 20 de outubro de 2025 é um teste da sua arquitetura. Se o seu serviço ficou fora, vale usar o incidente para montar a estratégia de recuperação antes da próxima.
O que os alunos dizem
“Eu sempre fugi da AWS. Achava complicado, distante da minha rotina de dev. Mas só a primeira aula do Bootcamp já mudou tudo: usei o conteúdo para resolver um problema real de um cliente e fui contratado por causa disso.”
André Scherrer, Engenheiro de Software
Ver depoimento
“Só quando coloquei a mão na massa com a Formação AWS é que avancei de verdade. Essa prática me levou ao próximo nível”
Caio, Desenvolvedor (Dev)
Ver depoimento
“Eu trabalhava há mais de 20 anos com TI tradicional e atendia empresas da região, mas sentia minha carreira estagnada.”
Carlos Souza, Consultor Cloud
Ver depoimento
Formação AWS
Aprenda AWS e IA na prática, com projeto real e acompanhamento. Converse com o time sobre a Formação AWS.
Agende uma conversaPrefere assistir?
A aula completa (15 min) está no canal Domine AWS. O vídeo toca aqui mesmo.