VPC Peering em caso real: região mais barata e o impacto no banco
Levar o banco de São Paulo para a Virgínia pode cortar o preço dele pela metade, mas, num cliente meu, a latência da aplicação foi de 100 para 600 milissegundos depois da mudança. Aqui você vê como eu achei a causa, por que não desfiz a mudança e o que resolveu sem devolver o custo.
O cenário: só uma parte da aplicação precisa estar no Brasil
Um dos caminhos para reduzir custo na AWS é usar regiões mais baratas. São Paulo é a região mais cara, e muita gente põe a aplicação lá por vários motivos. O primeiro e mais óbvio é o requisito de negócio: a aplicação precisa falar com algum órgão do governo e, por exigência ou bloqueio, não pode rodar num servidor internacional.
Foi o caso de um cliente meu. A solução inteira estava no Brasil. Depois da análise, ficou claro que a solução inteira não precisava estar: só a parte que se comunica com o governo.
A aplicação web dele tem duas camadas, que eu resumo assim:
- Worker. Consome trabalhos de uma fila SQS, faz processamento de dados em batch e só conversa com o banco de vez em quando. É ele quem fala com o governo federal, com governos estaduais e com outros serviços que exigem a aplicação no Brasil.
- API. Atende os usuários, que chegam por um sistema que o cliente já tinha, e tem uma comunicação bem maior com o banco.
Para tirar uma parte de São Paulo e manter a comunicação, usamos o VPC Peering: um canal que corre por dentro da rede da AWS e liga duas regiões, aqui São Paulo e a Virgínia (us-east-1). Com ele, você escolhe qual recurso vai trabalhar na região mais barata, e as duas partes continuam se falando por esse canal.
1Mover o banco e conferir o preço
A primeira ideia foi pegar o banco e levar para a Virgínia. Foi o que fizemos.
Para mostrar o tamanho do ganho, usei um exemplo de preço de lista, e não o banco do cliente: um RDS PostgreSQL sob demanda, com 4 vCPU e 32 GB de memória (db.r5.xlarge). O banco do cliente é outro, um SQL Server, como você vai ver adiante.
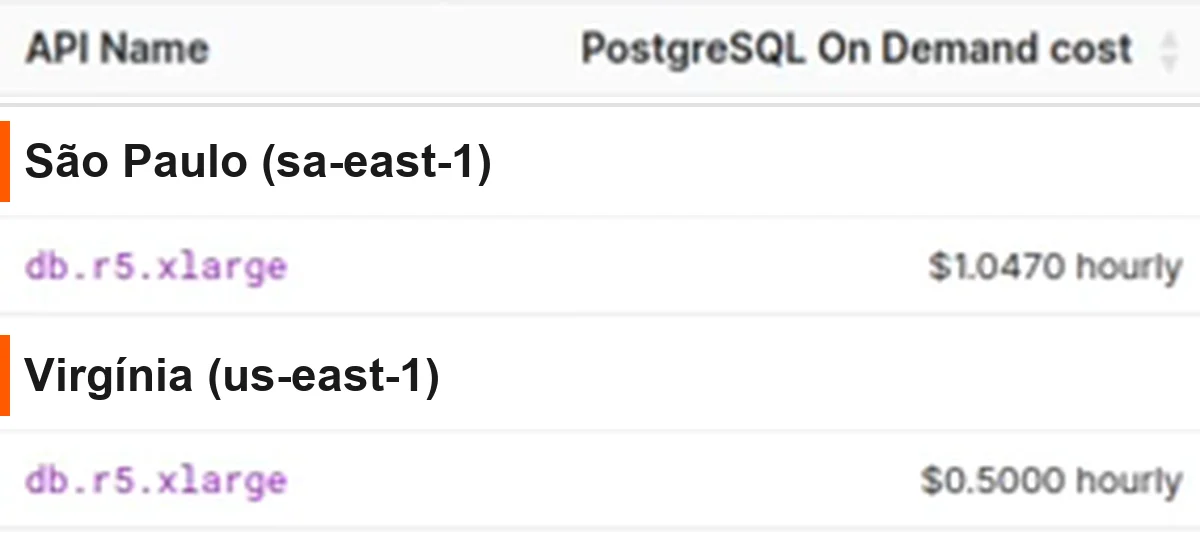
Na Virgínia, o preço fica em cerca de metade: no exemplo, 50% a menos no custo do banco só com a mudança. Você paga um pouco de data transfer entre as regiões, cobrado por giga. No cliente, o volume era pequeno e o custo de tráfego entre as regiões também.
O que quebrou: a latência subiu e o banco sofreu
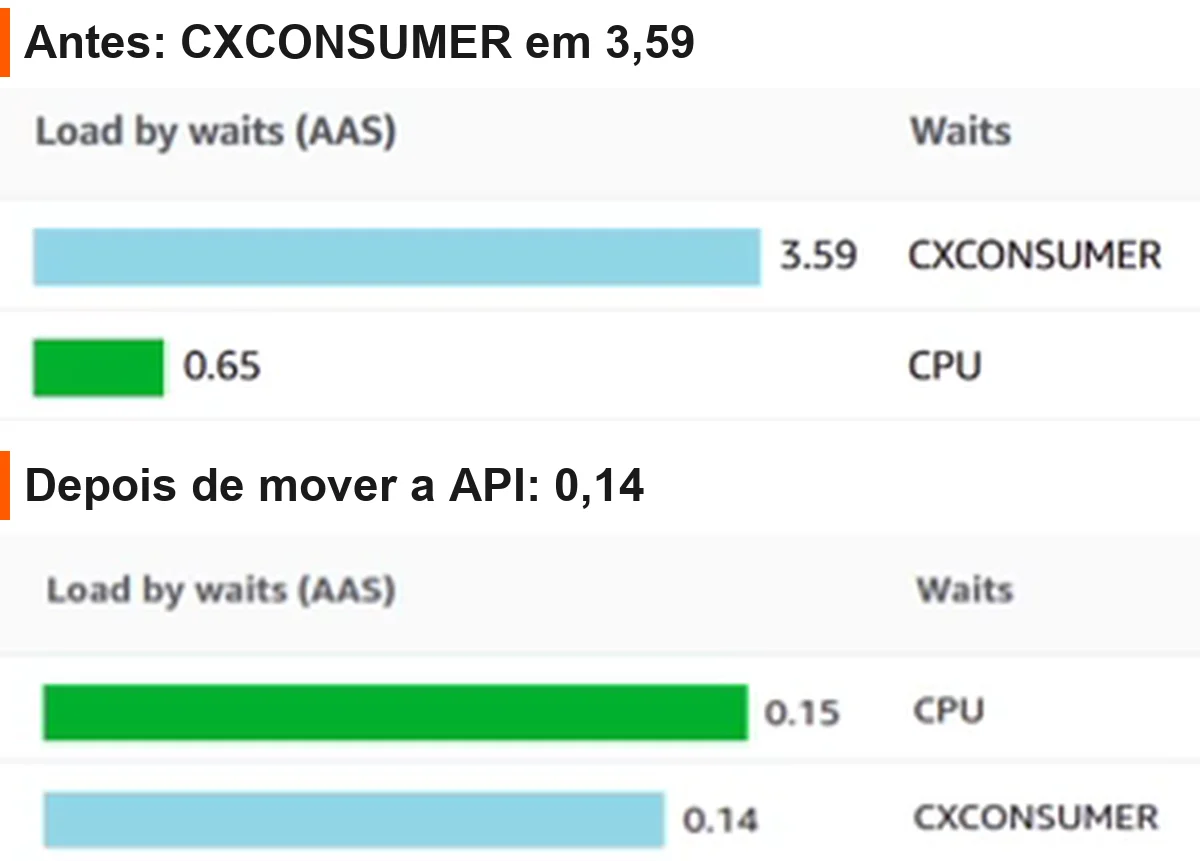
Com o banco na Virgínia e as duas camadas ainda em São Paulo, a aplicação inteira degradou. O Performance Insights do RDS do cliente, que é SQL Server, mostrava um consumo alto de uma espera chamada CXCONSUMER: 3,59 na carga por espera, com horas de pico bem maiores. Achei pouca informação sobre ela, e a que encontrei associava o CXCONSUMER ao paralelismo de operações.
O primeiro reflexo de quem não conhece a aplicação é voltar o banco para São Paulo. Isso resolve, mas devolve o custo. Antes de decidir, olhei as métricas. A aplicação estava no Elastic Beanstalk, que já traz bastante métrica por padrão, e uma delas é a latência:
- Antes: em torno de 100 milissegundos.
- Depois da mudança: 600 milissegundos.
- Ida e volta entre São Paulo e a Virgínia: de 150 a 200 milissegundos nos piores casos.
A distância explicava uns 200 milissegundos dos 500 a mais. Faltavam uns 300. Cruzando com as métricas de deadlock e de concorrência do RDS, o CXCONSUMER apontava a mesma coisa: a concorrência no banco estava subindo.
Por que a latência vira concorrência
Pense no número de conexões simultâneas que o banco aceita como um funil. No meu desenho, só para ficar fácil, o banco suporta 4 conexões ao mesmo tempo e cada uma leva 50 milissegundos. Em São Paulo, as 4 terminam no milissegundo 50 e a quinta já entra.
Agora some a latência da outra região, no pior caso 200 milissegundos: as 4 conexões passam a ocupar as vagas até o milissegundo 250. Se chega mais uma no milissegundo 50, não há vaga. Ela espera a janela de 200 milissegundos, começa só aos 250 e termina aos 500. O que levaria 200 passou para 500, e as próximas esperam em fila atrás dela.
Isso vira bola de neve: a espera segura as vagas, segura as próximas conexões e o gargalo piora. É um modelo simplificado, com números do desenho. O ponto é que latência entre região e banco não só soma tempo: ela segura a vaga de conexão por mais tempo.
2Mover a API junto do banco, e não desfazer
Cada aplicação tem as suas métricas. Não existe um número que seja saudável em geral, e por isso eu recomendo gastar tempo conhecendo a sua aplicação. Foi o que mudou a decisão.
Olhei as duas camadas:
- Worker. Não dava para mexer nele: é quem fala com o governo e precisa ficar em São Paulo. Além disso, ele conversa só de vez em quando com o banco e não mostrava grandes problemas. Dava para mitigar com cache ou outras soluções de código, mas o caso não pedia.
- API. Estava em São Paulo só porque os outros serviços estavam lá. Não tinha requisito de negócio para isso e era a camada com mais comunicação com o banco.
Então a mudança foi mover a API para a Virgínia, junto do banco. O worker continua em São Paulo e fala com o banco pelo VPC Peering:
3Medir de novo no Performance Insights
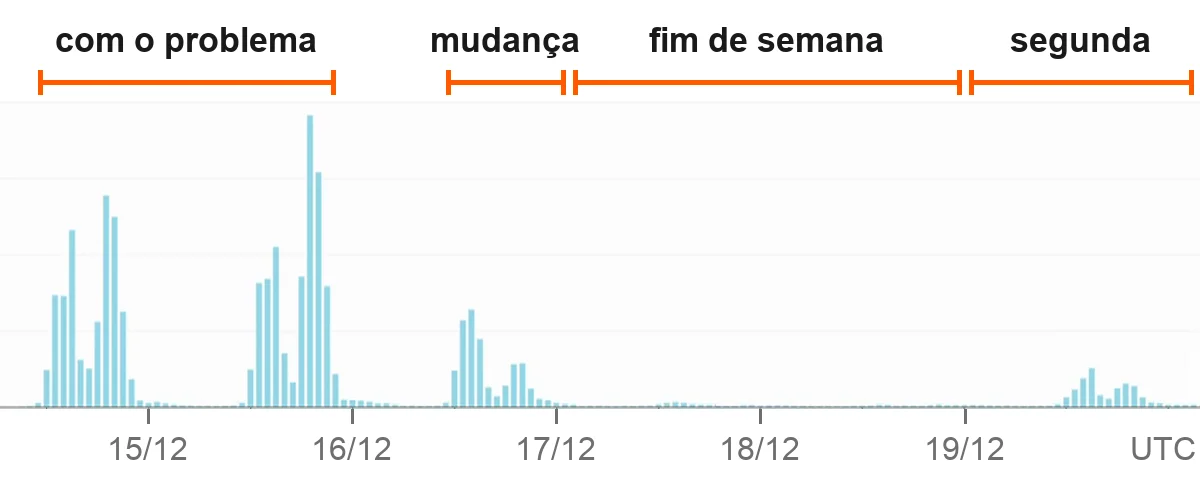
Antes, o CXCONSUMER estava em 3,59 na carga por espera do banco (AAS, sessões ativas médias). Depois de mover a API, ficou em 0,14. O problema foi resolvido.
O gráfico de carga de vários dias mostra a mesma virada. Os dois primeiros blocos são dias com o problema. No terceiro, a mudança entrou e o pico já é bem menor. Depois vem o fim de semana, quando essa aplicação não tem tráfego, e na segunda-feira a carga fica muito abaixo da dos dias com problema.
O Performance Insights traz muitas métricas. Quando você trabalha com RDS, habilite.
Com a decisão, o cliente não teve impacto no negócio e o ganho financeiro foi expressivo. Também implantamos cache nesse servidor, o que trouxe outro ganho e provavelmente vai permitir reduzir o tamanho do banco.
Saber a hora de parar
Fomos avançando enquanto havia resultado. O custo do tráfego entre as regiões era pequeno, então fazia sentido seguir, desde que não houvesse impacto no negócio. Conhecer a aplicação serviu para não dar rollback às cegas e continuar na estratégia de custo.
Checklist
- Liste o que da sua aplicação tem requisito de negócio para ficar em São Paulo e o que não tem.
- Compare o preço do mesmo recurso nas duas regiões, na página oficial.
- Meça o volume de data transfer entre as regiões antes de decidir.
- Habilite o Performance Insights do RDS.
- Anote a latência da aplicação antes da mudança, para comparar depois.
- Se a latência subir, olhe concorrência e deadlock no banco antes de desfazer.
- Mova junto do banco a camada que fala muito com ele e não tem requisito de ficar no Brasil.
- Meça de novo e decida se avança ou se para.
Mover só o que não precisa ficar no Brasil, medindo cada passo e sem desfazer às cegas, foi o que manteve a economia. Se você quer apoio para decidir o que pode sair de São Paulo na sua aplicação, o ponto de partida é conhecer a aplicação.
O que os alunos dizem
“Eu queria voltar para a área técnica, mas aprender AWS sozinho só me deixava frustrado.”
William Santos, Tech Lead
Ver depoimento
“Eu sempre fugi da AWS. Achava complicado, distante da minha rotina de dev. Mas só a primeira aula do Bootcamp já mudou tudo: usei o conteúdo para resolver um problema real de um cliente e fui contratado por causa disso.”
André Scherrer, Engenheiro de Software
Ver depoimento
“Só quando coloquei a mão na massa com a Formação AWS é que avancei de verdade. Essa prática me levou ao próximo nível”
Caio, Desenvolvedor (Dev)
Ver depoimento
Formação AWS
Aprenda AWS e IA na prática, com projeto real e acompanhamento. Converse com o time sobre a Formação AWS.
Agende uma conversaPrefere assistir?
A aula completa (26 min) está no canal Domine AWS. O vídeo toca aqui mesmo.