x86 ou ARM na AWS: teste de carga com T3 e T4G no ECS
A T4G, de arquitetura ARM, custa menos por hora que a T3, de arquitetura x86. Mas aguenta a mesma carga? Em fevereiro de 2024 coloquei a mesma API Node nas duas, no ECS, sob o mesmo teste de carga.
Aqui você vê como montar esse teste e como ler o resultado: tempo de resposta, momento em que cada instância escala e o que a troca de arquitetura muda no custo por hora.
O cenário: a mesma aplicação em duas arquiteturas
Dois anos antes eu tinha feito um vídeo comparando instâncias sem aplicação nenhuma, só com uma ferramenta de teste de CPU. Desta vez quis um cenário real: peguei uma API e montei um ambiente completo.
A aplicação é uma API em Node. Ela roda em dois clusters no ECS, um com instância T3 micro e outro com T4G micro:
- T3 micro: arquitetura x86, a instância da camada gratuita, normalmente a que a gente usa para começar um projeto.
- T4G micro: arquitetura ARM, com os processadores Graviton da AWS.
A diferença que me interessava é o preço. Na tabela de instâncias que usei (o instances.vantage.sh, região N. Virginia, custo sob demanda), a T3 micro custa US$ 0,0104 por hora e a T4G micro, US$ 0,0084.
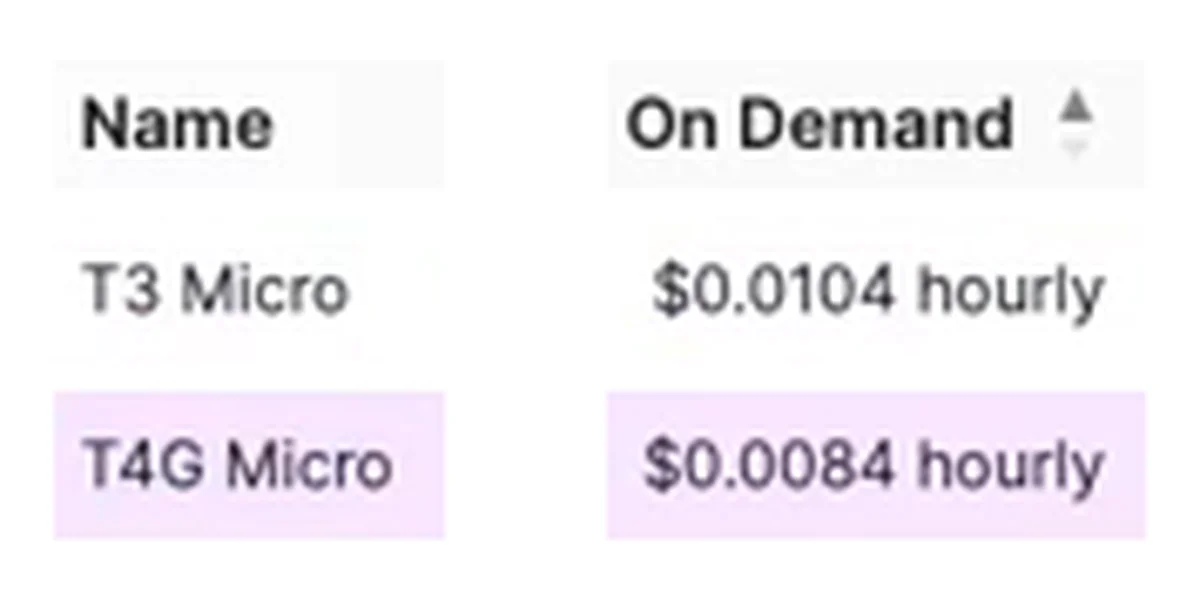
Isso dá cerca de 7,5 dólares por mês na T3, com a T4G aproximadamente 20% mais barata. Os indicadores são equivalentes: a mesma tabela mostra 1 GiB de memória e 2 vCPUs nas duas.
São valores de fevereiro de 2024, citados na aula. Antes de decidir, confira na página de preços do EC2.
1Monte os dois ambientes iguais
Cada arquitetura ganha o seu ambiente, e o cenário é igual nos dois:
- Um cluster no ECS, com uma instância (T3 micro em um, T4G micro no outro).
- Um Application Load Balancer na frente de cada cluster, com o target group apontando para uma task rodando.
- Escalabilidade configurada nos dois: cada serviço pode subir mais uma task, ficando com duas no máximo. O gatilho é CPU acima de 10%.
2Use uma rota que gasta CPU
Para estressar a aplicação, pedi ao ChatGPT um algoritmo de teste e ele devolveu o Fibonacci. Na sequência de Fibonacci, cada número é a soma dos dois anteriores: 0, 1, 1, 2, 3, 5, 8, e assim por diante. Calcular uma posição como a 25 exige muito processamento, e é o que eu queria: consumo forte de CPU.
A rota /api/loadTest recebe a posição no parâmetro n:
function fibonacci(num) {
  if (num <= 1) return num;
  return fibonacci(num - 1) + fibonacci(num - 2);
}
Sem parâmetro, ela resolve a posição 20. Com n=25 demora um pouco mais, com 30 mais ainda, e assim por diante.
A posição 25 foi a que encontrei como boa para estressar a aplicação e ainda obter resposta, então foi com ela que trabalhei. Antes do teste, chamei a rota com n=25 nas duas instâncias, e as duas resolveram, fazendo o mesmo trabalho.
3Configure e rode o teste de carga
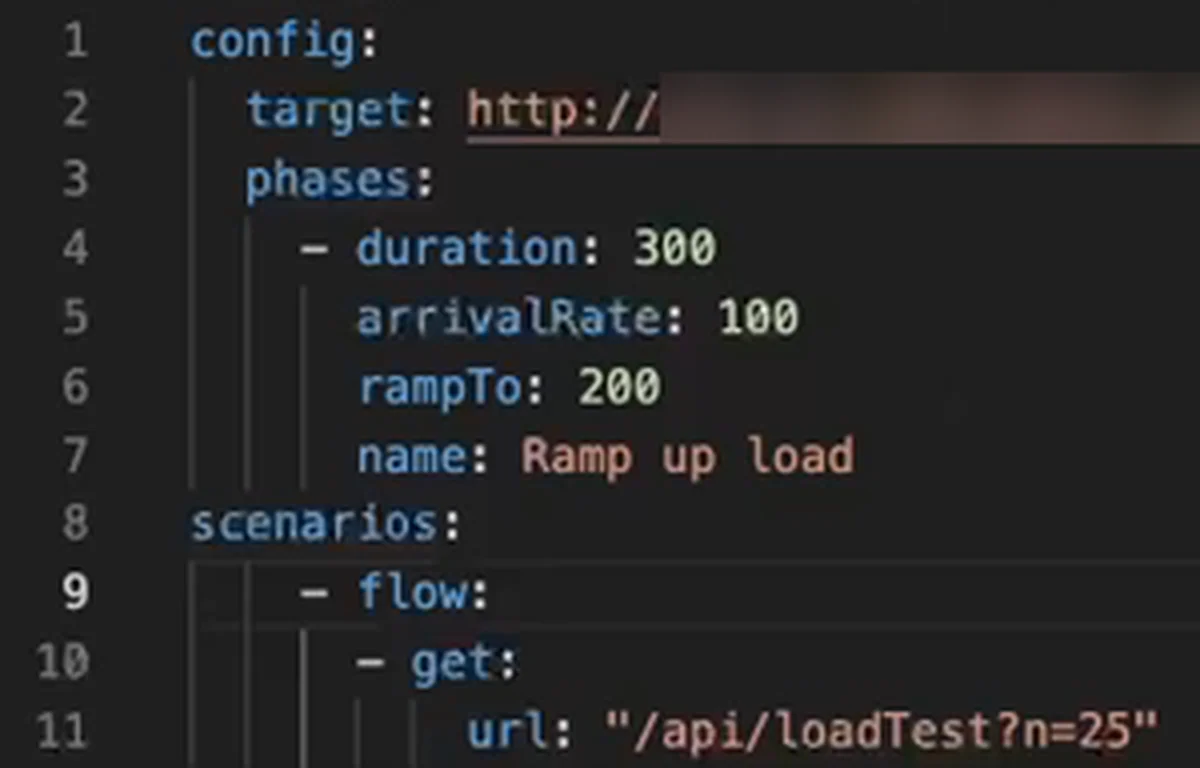
Usei o Artillery. Um arquivo YAML diz qual é a rota, quanto tempo o teste dura, quantos usuários virtuais começam e até quanto ele chega, subindo de forma gradual. O meu, igual para as duas instâncias, só trocando o endereço do load balancer:
config:
  target: http://<dns-do-load-balancer>
  phases:
    - duration: 300
      arrivalRate: 100
      rampTo: 200
      name: Ramp up load
scenarios:
  - flow:
      - get:
          url: "/api/loadTest?n=25"
São 5 minutos (duration: 300), começando em 100 e subindo até 200 usuários virtuais, batendo na posição 25 do Fibonacci. Um arquivo para a T3 e outro para a T4G. Rodei os dois ao mesmo tempo, cada um no seu terminal:
artillery run load_test_t3.yml
artillery run load_test_t4g.yml
4Leia os resultados
O Artillery imprime um relatório a cada 10 segundos. Os dois números que eu olho são o P95 e o P99: o P95 de 102 ms, por exemplo, quer dizer que 95% das requisições foram resolvidas em até 102 milissegundos.
No começo, no primeiro intervalo que mostrei, a T3 estava com P95 de 125,2 ms e P99 de 135,7 ms. A T4G, com P95 de 102,5 ms e P99 de 115,6 ms. Nenhum erro nesses primeiros intervalos. A mesma aplicação, só com a arquitetura trocada e numa instância mais barata, já respondia mais rápido.
Com a carga subindo, a distância entre as duas foi aumentando: a T3 começou a sofrer mais. No CloudWatch, os alarmes das duas tinham disparado, com a CPU lá em cima, e as duas escalaram para duas tasks.
A T3 escalou primeiro: a segunda task dela tinha 2 minutos de vida e a da T4G, 36 segundos. O gatilho da T3 foi acionado antes porque o uso de CPU dela subiu primeiro.
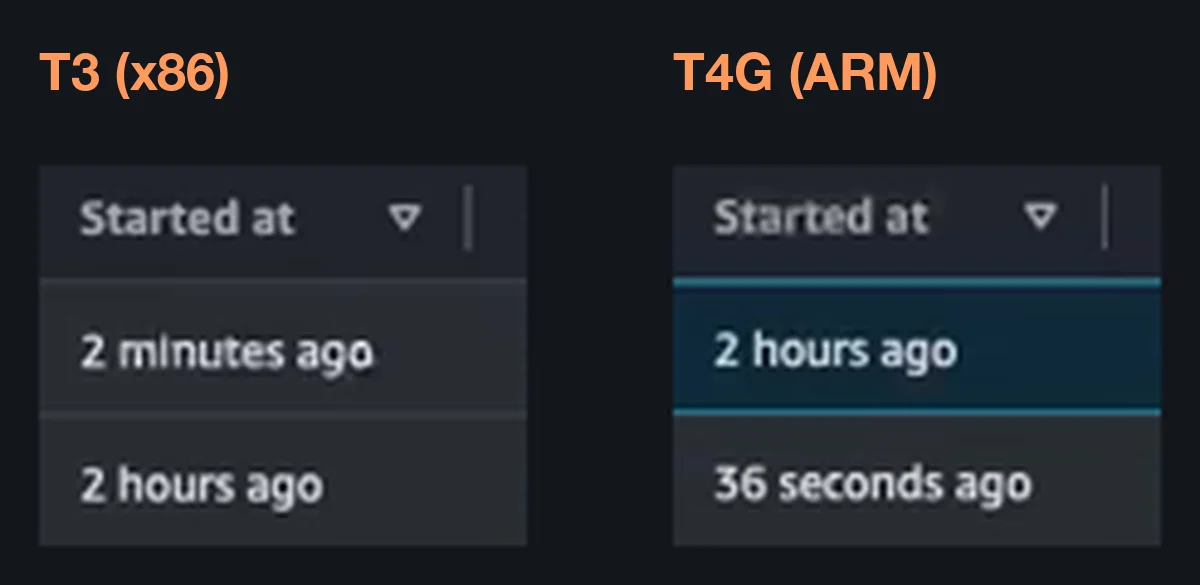
Perto do fim começaram a aparecer falhas, entre elas erros 502 (bad gateway), porque o volume de requisições ficou muito alto. Falei na hora que a aplicação começava a abrir o bico e que o comportamento da que roda em ARM estava consideravelmente melhor.
O teste terminou em 5 minutos, as duas com duas tasks, que era o teto que eu tinha configurado.
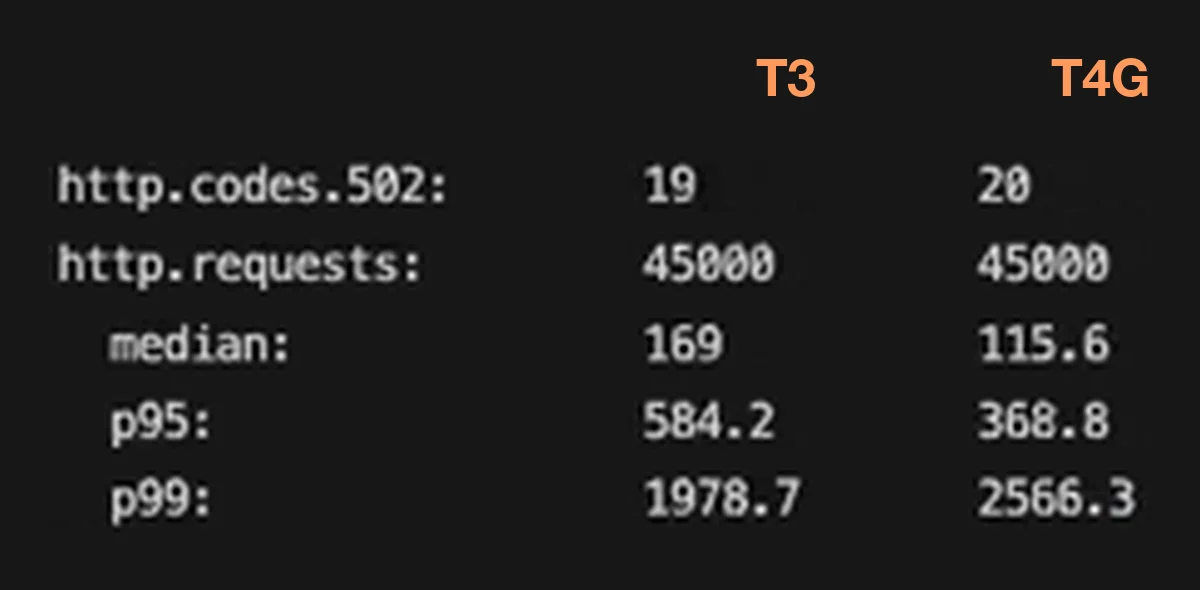
Os números completos do relatório final, com tempo de resposta em milissegundos:
| T3 micro (x86) | T4G micro (ARM) | |
|---|---|---|
| Mediana | 169 | 115,6 |
| Média | 261,8 | 184,7 |
| P95 | 584,2 | 368,8 |
| P99 | 1.978,7 | 2.566,3 |
| Máximo | 5.112 | 4.618 |
| Respostas 502 | 19 | 20 |
O Artillery enviou 45.000 requisições a cada uma. Mediana, média e P95 foram menores na T4G. O P99 foi maior na T4G (2.566,3 contra 1.978,7 ms), e os erros 502 ficaram praticamente empatados (19 e 20).
Os dois relatórios também mostram 8 erros ENOTFOUND, iguais nos dois lados.
O que o teste mostra e o que não mostra
Minha conclusão no vídeo: do ponto de vista de CPU, a aplicação na T4G ficou cerca de 20% mais barata, demorou mais para escalar e aguentou mais volume de requisições. Para trabalhar com a T4G, dá para perceber que há ganhos.
A tabela final eu não comentei no vídeo. E é um teste simples: usei o Fibonacci só para estressar a CPU e ver como a aplicação escala. Outros testes podem ser feitos.
Os 20% são a diferença do preço da instância por hora (US$ 0,0104 contra US$ 0,0084). Esse número não inclui o trabalho de compilar a aplicação para ARM.
Checklist
- Compare o preço da instância que você usa hoje com o da T4G, na região que você usa, na página oficial de preços.
- Compile a aplicação para ARM e suba a mesma aplicação nas duas arquiteturas.
- Monte dois ambientes iguais: cluster, load balancer, target group e regra de escala.
- Escolha uma rota que gaste CPU e fixe o parâmetro (aqui,
n=25). - Rode o Artillery nos dois ambientes ao mesmo tempo, com a mesma configuração, trocando só o endereço do load balancer.
- Compare mediana, média, P95, P99 e erros no relatório final, e o momento em que cada ambiente escalou.
A ideia do teste foi olhar custo e performance juntos, com uma aplicação real, antes de decidir qual instância usar.
O que os alunos dizem
“Eu queria voltar para a área técnica, mas aprender AWS sozinho só me deixava frustrado.”
William Santos, Tech Lead
Ver depoimento
“Eu sempre fugi da AWS. Achava complicado, distante da minha rotina de dev. Mas só a primeira aula do Bootcamp já mudou tudo: usei o conteúdo para resolver um problema real de um cliente e fui contratado por causa disso.”
André Scherrer, Engenheiro de Software
Ver depoimento
“Só quando coloquei a mão na massa com a Formação AWS é que avancei de verdade. Essa prática me levou ao próximo nível”
Caio, Desenvolvedor (Dev)
Ver depoimento
Formação AWS
Aprenda AWS e IA na prática, com projeto real e acompanhamento. Converse com o time sobre a Formação AWS.
Agende uma conversaPrefere assistir?
A aula completa (20 min) está no canal Domine AWS. O vídeo toca aqui mesmo.