Migrar SQL Server para Aurora Babelfish: o caso de um banco de 3 TB
Um SQL Server de 3 TB com CPU entre 80% e 90%, fila de operações em 300 e uma licença maior cara demais para o negócio: esse era o banco de um cliente meu. Mostro aqui como levamos esse banco para o Aurora PostgreSQL com Babelfish sem reescrever a aplicação, o que pegou no caminho e o que mudou em desempenho e custo.
O cenário: um SQL Server de 3 TB sem fôlego
O banco era um SQL Server com 3 TB, em produção, no RDS. A instância não aguentava a demanda e já estava perto da última da família. Uma licença maior traz instâncias maiores, mas o custo compromete a viabilidade do negócio. Os sintomas:
- CPU alta, na faixa de 80% a 90%.
- Queue depth altíssimo. Mede o enfileiramento das operações que chegam ao banco. O saudável fica entre 0 e 1. O nosso chegava a 300.
- Backup pesado. Quando rodava, a aplicação meio que parava. Era na madrugada e muitas vezes se estendia.
- Manutenção lenta. Reorganizar e reconstruir índices demorava e muitas vezes nem funcionava.
- Sem espelho rápido. Para investigar um bug numa cópia da produção, era preciso restaurar um backup, e isso levava muitas horas.
O que é o Babelfish e por que ele muda a conta
O Aurora PostgreSQL é o PostgreSQL redesenhado pela AWS. O Babelfish é um conjunto de extensões que a AWS plugou em cima dele. Com ele ligado, o cluster aceita conexão de aplicação SQL Server (T-SQL, porta 1433) e de aplicação PostgreSQL (porta 5432). Por baixo, os dados ficam guardados no PostgreSQL.
Depois da migração, só trocamos a connection string. A aplicação era .NET com Entity Framework e não foi reescrita. Num banco desse tamanho, um índice ou outro precisou ser reajustado, e só.
E a conta muda: a hora da instância custa bem menos, você fica livre da licença do SQL Server e o armazenamento também é mais barato.
O caminho, do teste ao banco ajustado:
1Testar a aplicação com o Babelfish
Antes de migrar, faça uma prova de conceito: rode a aplicação contra o Babelfish e veja o que acontece. Use uma homologação com 10% a 20% dos dados de produção. Não precisa do volume inteiro: esse tanto já dá previsibilidade do que vai acontecer.
2Migrar os dados com o DMS
Esta é a etapa mais delicada. A primeira ideia foi o import e export do próprio SQL Server, mas com 3 TB levaria mais de uma semana. Não dá para parar uma produção por uma semana.
O AWS DMS (Database Migration Service) resolveu. Ele transfere os dados da origem (SQL Server) para o destino (Aurora com Babelfish), a partir de um mapeamento que você faz. O que ele pediu:
- Equilibre origem e destino. O DMS era tão rápido que ora derrubava o SQL Server de origem, ora o PostgreSQL de destino. Se um cai, a transferência para.
- Configure os logs e erros. Depois de configurados, o que acontece fica visível no CloudWatch.
- Desative as constraints no destino (foreign keys e primary keys). Com elas ligadas, a transferência valida cada dado e fica extremamente lenta. Terminada a carga, se os dados estiverem 100% íntegros, reative tudo.
- Prepare-se para o pior cenário. Planejamos 8 horas, e a migração levou 19. O banco entrou em leitura depois de 12 horas, e mais 7 horas completaram a migração.
Paralelismo: de 16 horas para cerca de uma hora e meia
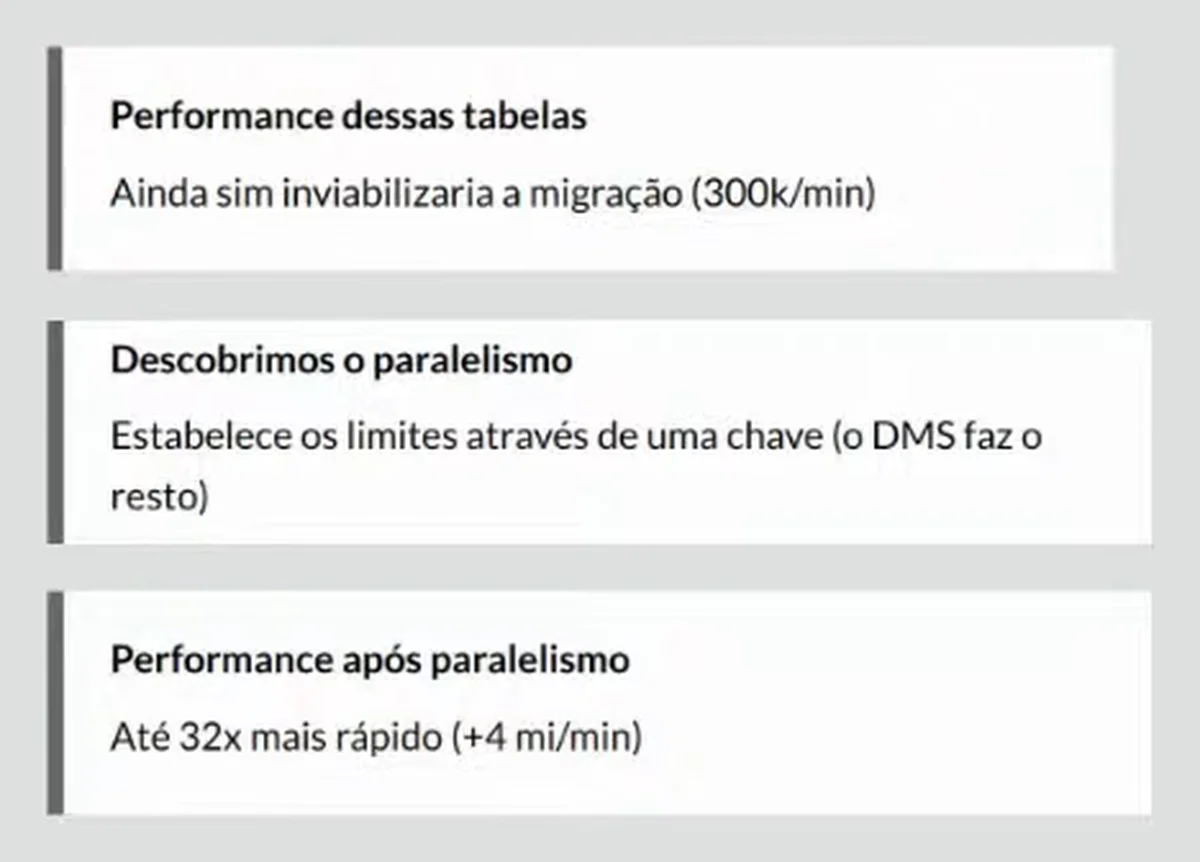
Num banco relacional, muitas vezes os dados se concentram em poucas tabelas. Aqui, uma tinha mais de 300 milhões de registros. O DMS transferia cerca de 300 mil registros por minuto: só essa tabela levaria 16 horas.
O DMS faz paralelismo: você define os limites a partir de uma chave. A nossa era um GUID, então definimos faixas de GUID e rodamos as faixas em paralelo. A transferência foi a cerca de 4 milhões de registros por minuto, e a tabela caiu de 16 horas para uma hora, uma hora e meia.
3Ajustar índices e consultas
Veio então a fase de maturação. Nem todo índice replicado passou a ser usado pelo PostgreSQL, e algumas consultas não usavam os índices que replicamos.
No começo, o custo ficou maior que o do SQL Server: começamos numa instância maior e fomos reduzindo com o tempo. Pelo Performance Insights do RDS, vimos que o problema estava nos índices. Recriamos os índices, melhoramos algumas consultas para usá-los, e o custo começou a cair. A aplicação não precisou de mudança específica.
Dois aprendizados: o cache do PostgreSQL, o shared buffer, é muito diferente do cache do SQL Server. E as ferramentas de gerenciamento que você usava talvez não sirvam mais.
O que mudou depois da migração
O processo todo levou mais de seis meses, quase um ano para se consolidar. Teve momento em que o custo ficou mais alto, mas o cliente acreditou no projeto. Alinhe com a gestão o que deu certo e errado em cada fase.
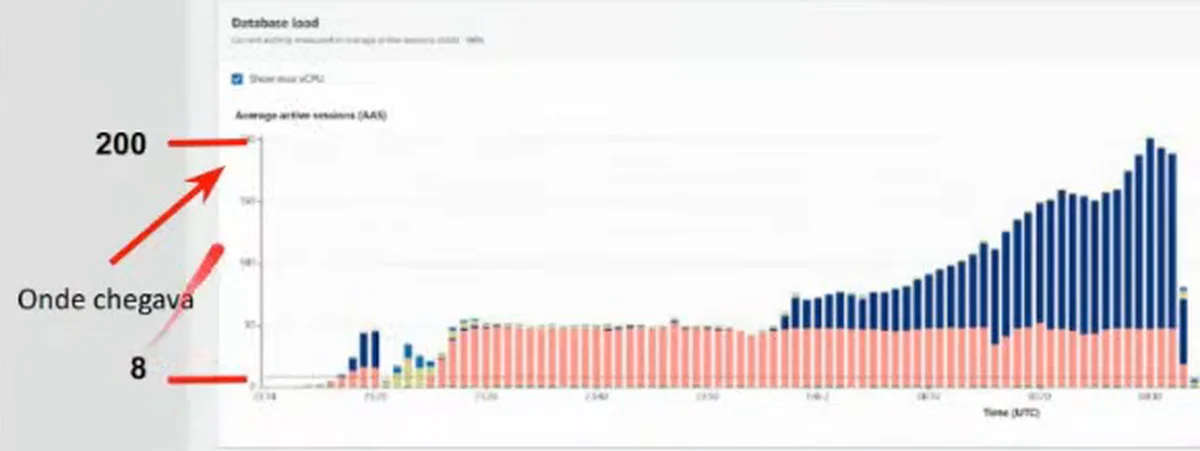
- CPU voltou à normalidade, e o queue depth ficou entre 0 e 1.
- Escrita até 20 vezes mais rápida em alguns ciclos: operações de 2 segundos passaram a levar 100 milissegundos.
- Armazenamento caiu de 3 TB para 1,1 TB. Ninguém foi a fundo na causa; desconfiamos de logs e índices fragmentados.
- Mais 400 GB liberados quando uma ferramenta plugada no Aurora apontou índices sem uso e nós os tratamos.
- Storage que encolhe. O SQL Server não deixa reduzir o storage alocado; o Aurora cobra pelo que você usa.
Sem licença, ficou viável o que antes era caro. O banco nem tinha Multi-AZ, porque a licença que o suportava custava demais. Com o Aurora dá para usar cluster com réplica de leitura a partir da menor instância (instâncias maiores são recomendadas).
Veio também o clone, que trabalha por diferença. Em cerca de 5 minutos você tem uma cópia do banco de 3 TB, que começa com tamanho zero e só cresce com o que você modifica. Para investigar um problema: clone, mexa, valide e jogue fora.
E reorganizar e reconstruir índices deixou de ser preocupação contínua: no PostgreSQL, o autovacuum faz esse trabalho.
Os números de custo
Na apresentação usei valores hipotéticos, para não expor os números do cliente: trate como exemplo, não como o gasto dele. No exemplo, o SQL Server custava 10 mil dólares e, sem o Aurora, a próxima instância custaria 16 mil. Com o Aurora, partimos de 10 mil e chegamos a 7.520 dólares, mesmo com mais poder computacional.
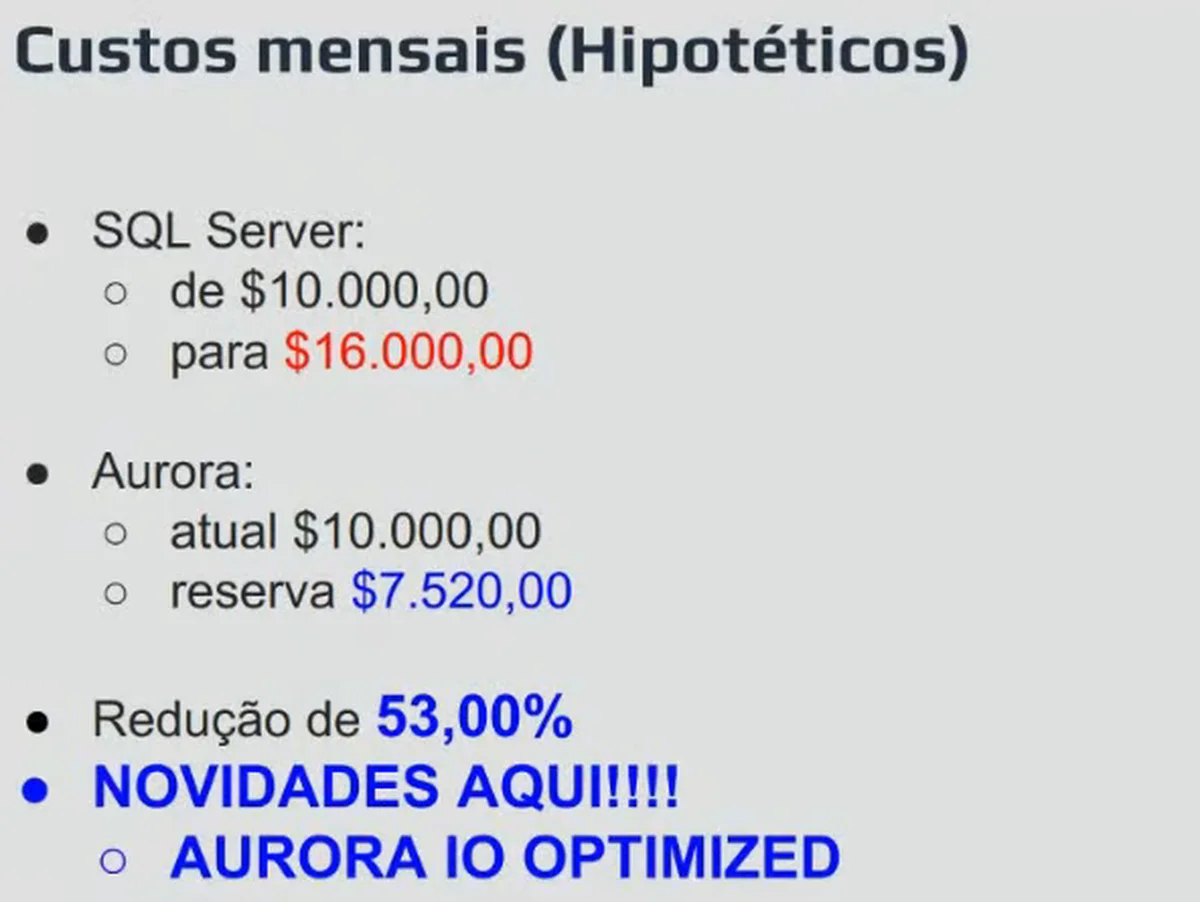
Os 53% do slide só fecham contra os 16 mil (7.520 é 47% de 16 mil). Contra os 10 mil de partida, a queda seria de cerca de 25%. Do caso real, afirmo só uma redução de custo de mais de 50%.
O custo de I/O do storage era cerca de 20% do total. Uma semana depois da minha apresentação, a AWS lançou o Aurora I/O-Optimized, que troca o custo variável de I/O por um fixo. Com ele, a redução passou de 53% para mais de 60%. São valores de 2023: confira os preços atuais na página de preços do Aurora.
Cuidado com o custo da POC
A transferência de dados foi um dos maiores custos do projeto: fizemos a carga completa umas 3 vezes antes da produção. Na época não conversamos com a AWS. Depois, ao apresentar o caso a eles, ouvimos que poderíamos ter pedido verba de POC. Se a sua conta tem um consultor, converse com ele antes.
Checklist
- Teste a aplicação no Babelfish, numa homologação com 10% a 20% dos dados de produção.
- Desative foreign keys e primary keys no destino durante a carga com o DMS e reative no fim.
- Paralelize o DMS por uma chave nas tabelas maiores.
- Configure os logs de erro do DMS e acompanhe no CloudWatch.
- Planeje a janela para o pior cenário.
- Reserve uma fase de maturação para recriar índices e ajustar consultas.
- Alinhe cada fase com a gestão, inclusive quando o custo sobe.
- Converse com a AWS sobre verba de POC antes de começar.
O DMS resolveu a migração dos dados depois que aprendemos a configurá-lo. O resto veio da maturação.
O que os alunos dizem
“Eu sempre fugi da AWS. Achava complicado, distante da minha rotina de dev. Mas só a primeira aula do Bootcamp já mudou tudo: usei o conteúdo para resolver um problema real de um cliente e fui contratado por causa disso.”
André Scherrer, Engenheiro de Software
Ver depoimento
“Eu trabalhava há mais de 20 anos com TI tradicional e atendia empresas da região, mas sentia minha carreira estagnada.”
Carlos Souza, Consultor Cloud
Ver depoimento
“A Formação AWS me deu segurança técnica para voltar ao mercado e ser a escolha certa para a empresa.”
Flávio Lucena, Gestor de TI
Ver depoimento
Formação AWS
Aprenda AWS e IA na prática, com projeto real e acompanhamento. Converse com o time sobre a Formação AWS.
Agende uma conversaPrefere assistir?
A aula completa (55 min) está no canal Domine AWS. O vídeo toca aqui mesmo.